生视频 ● 运行正常 服务状态 →
MiniMax H3
⧉minimax-h3
MiniMax H3 是 MiniMax 2026 年 7 月发布的第三代视频模型,能把文字、图片、视频和音频放在一起理解,画面和对白、音效、配乐一次生成。在 KovAPI 用 minimax-h3 调用:480P、768P、1080P 三档,4–15 秒任选,按秒计费。
- 480P每秒$0.015起
- 4–15秒任意整秒
- 首尾帧+参考视频
- 768P比官方低68%
在线测试
直接试一下 MiniMax H3 的效果(登录后可用)。
Input
0 / 5000 字
参考图0 / 9
点击上传,或把文件拖到这里
jpg / png / webp,单张不超过 16MB;宽高 256–5760 像素,宽高比 0.4–2.5
或粘贴链接
一行一个链接(公网 http(s),或我们的链接)。
「参考图」:最多 5 张,图里的人物或场景会出现在视频里,还可以加参考音频和参考视频;「首尾帧」:第 1 张作首帧、第 2 张作尾帧(首尾帧模式不能加参考音视频)。不带图为文生视频。
参考视频0 / 3
点击上传,或把文件拖到这里
mp4 / mov,单个不超过 50MB;所有参考视频合计最长 15 秒
或粘贴链接
一行一个链接(公网 http(s),或我们的链接)。
参考视频只能在「参考图」用法下用:最多 3 段、合计 30 秒,可以和参考图一起传。它会影响成片的动作和画面,但不会逐帧照搬。参考视频的秒数也计费:费用 =(输出秒数 + 参考视频秒数)× 每秒单价。
参考音频0 / 3
点击上传,或把文件拖到这里
mp3 / wav,每段 2–15 秒、合计不超过 15 秒,单个不超过 15MB
或粘贴链接
一行一个链接(公网 http(s),或我们的链接)。
需要同时有参考图或参考视频;提示词里用 @Audio1 点名。
上传的参考素材保留 7 天。
这就是 POST /v1/videos/generations 的请求体,可以直接改;切回「表单」或点运行时生效。
视频生成通常 5–20 分钟;上游繁忙时可能长到 60 分钟以上(满 120 分钟仍未生成按超时处理,积分全额退还)。请轮询任务号等待,不要重复提交——重复提交会各自扣费。按秒计费、失败全额退。 提示词上限 5000 字(中英文都按字数算)。
Output
video示例结果:输入区预填的就是生成这条视频用的全部素材——3 张参考图(人物、萨摩耶、咖啡店)和 1 段参考视频(提供动作),1080P · 6 秒 · 16:9。点播放就能看;点「运行」会用同样的素材重新生成一条(每次结果都不一样),按输出秒数加参考视频秒数计费。
🕑 生成的图片和视频保留 7 天,到期自动删除,请及时下载保存。
一次生成画面和声音,开头结尾、人物和动作都能定
下面的预览都来自本页案例的成片。点「看完整案例」看带声音的原片、提示词和参数;「相关案例」里是用到同一能力的其他成片。
鼠标移到画面上播放
多镜头与对白
镜头、台词、音效按提示词的时间线走
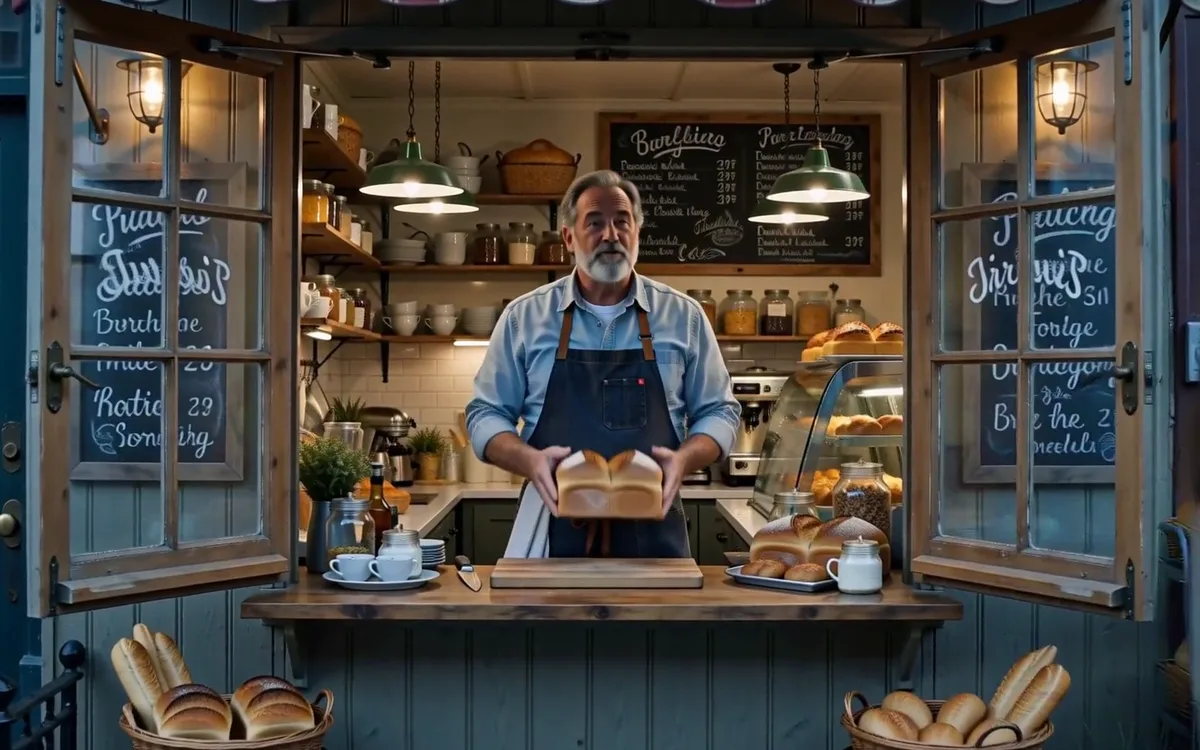
按官方格式分镜头写,切换时间、台词、环境声和配乐都照提示词来。面包店这条在第 5 秒切到切面包的特写,面包师的台词一字不差,木吉他配乐也是提示词里写的。
相关案例
鼠标移到画面上播放
首帧与首尾帧
定好开头,或者开头和结尾都定好
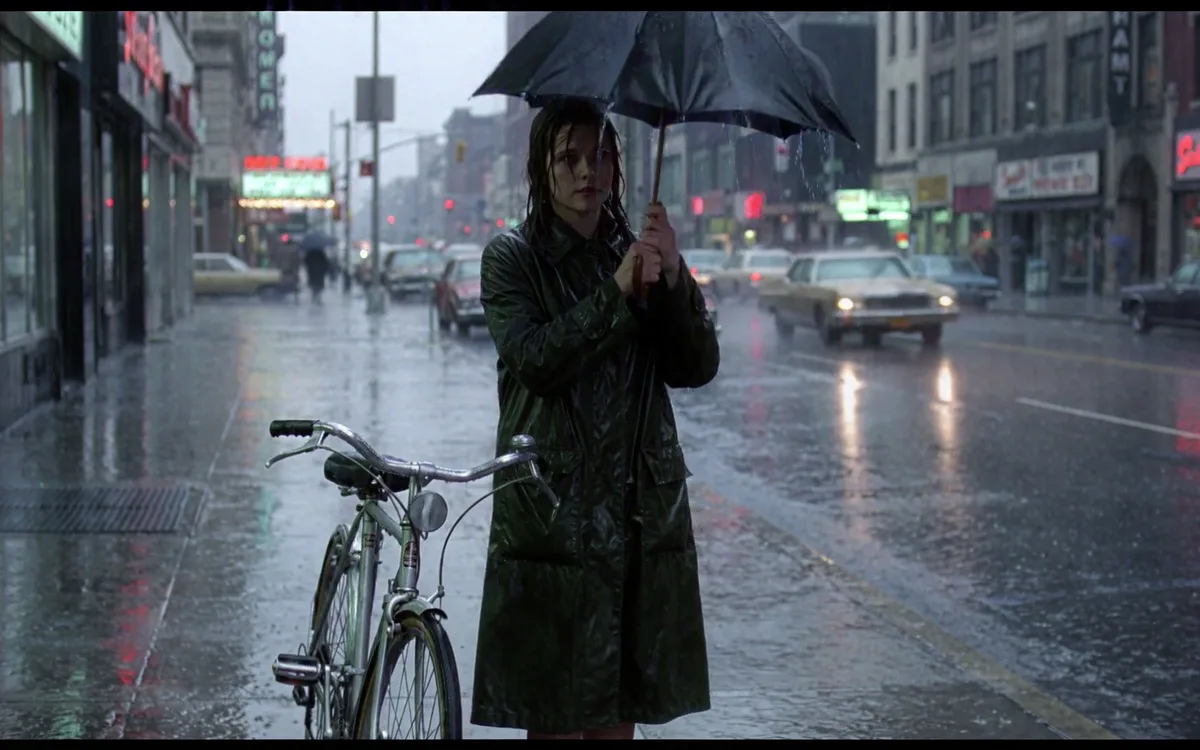
1 张图作首帧,成片从这张图开始拍;2 张图作首尾帧,中间的动作由模型补全。撑伞这条从收着伞的第一张图开始,最后停在撑开伞的第二张图上。
相关案例
鼠标移到画面上播放
参考图
人物和商品照参考图,按你写的方式组合
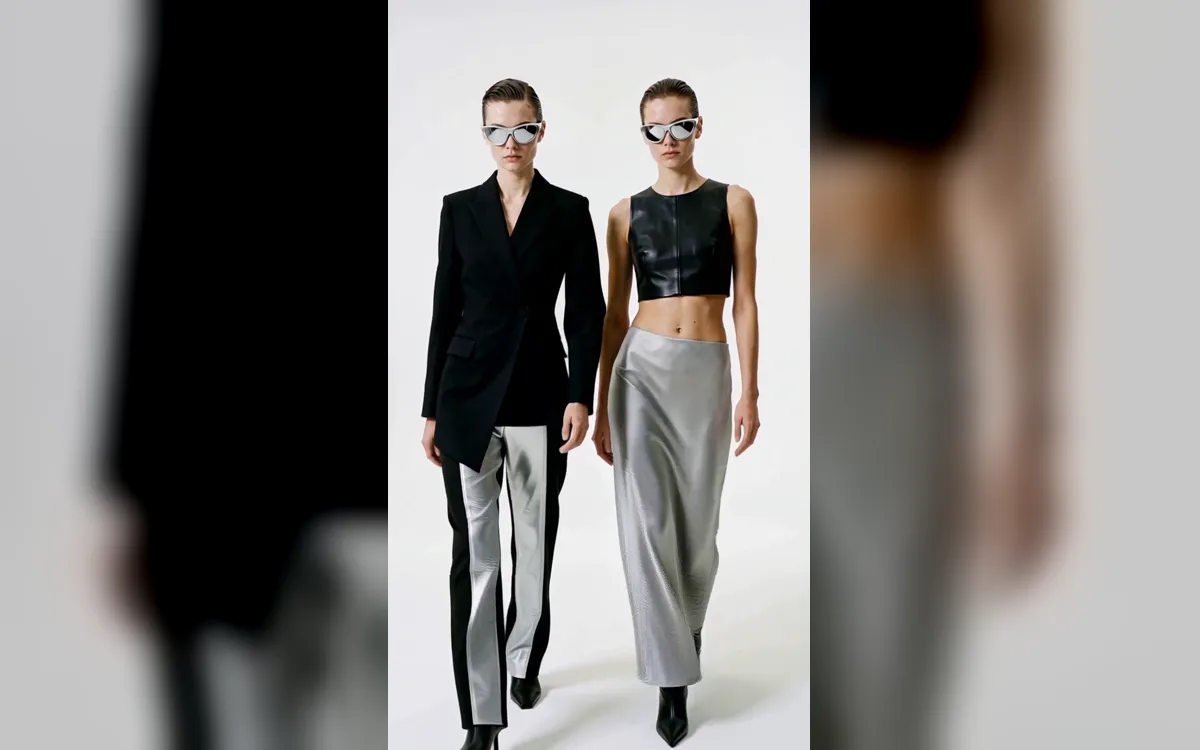
参考模式最多 9 张图。眼镜广告这条放了模特、面部和眼镜三张图,按官方参考篇的结构写清每张图的作用,模特戴上这副眼镜走台步,再切到特写。
相关案例
鼠标移到画面上播放
参考视频
借参考视频的动作和运镜
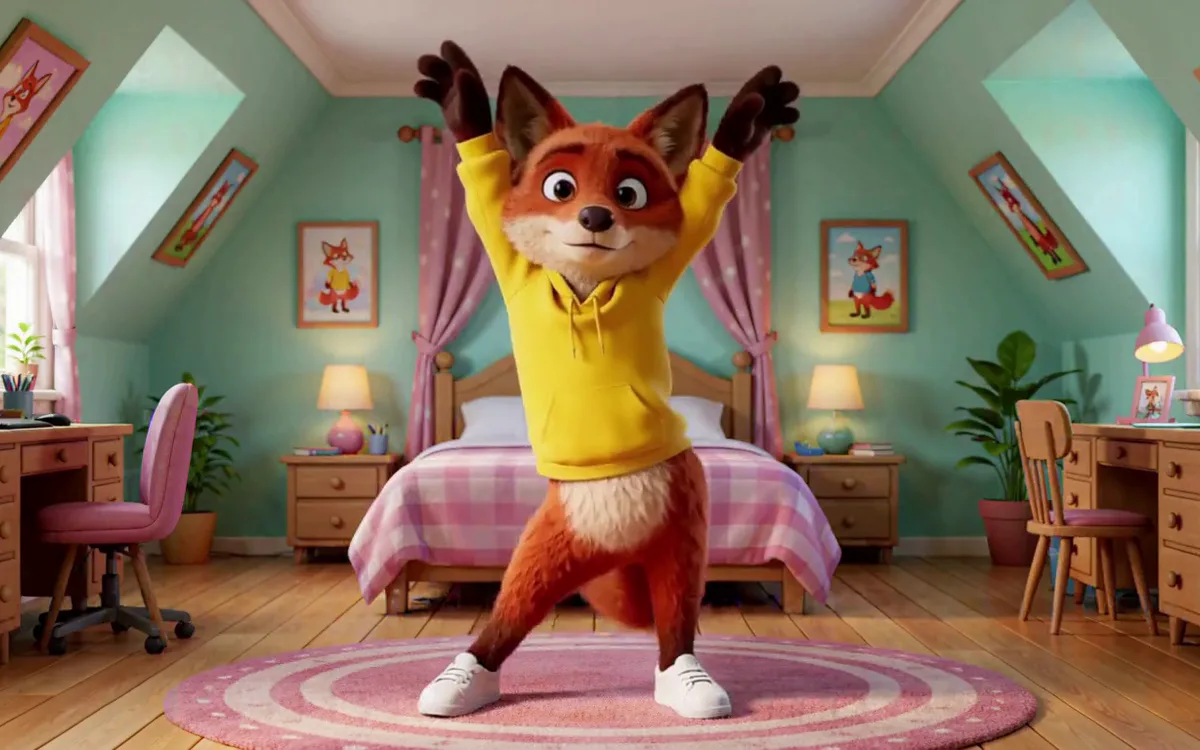
左边是参考视频,右边是成片:卡通狐狸照着真人跳了同一段动作。参考视频也可以只提供运镜,画面里拍什么由参考图和提示词决定。参考视频的秒数也计费。
相关案例
鼠标移到画面上播放
三档清晰度
480P 打样,1080P 出片
480P / 768P / 1080P 三档,8 种画幅,4–15 秒任意整秒。先用 480P 或 Lite 看构图和动作,定稿再出 1080P;换档会重新生成,画面不会一模一样,下面的同题对比可以直接看差别。
相关案例
能拿 MiniMax H3 做什么
MiniMax H3 规格速查
- 型号 ID
minimax-h3·minimax-h3-lite- 接口
POST https://kovapi.com/v1/videos/generations→GET https://kovapi.com/v1/videos/jobs/{id}- 时长
- 4–15 秒,整数
- 分辨率
- 480P / 768P / 1080P,不写时 1080P;传 720P 按 768P 处理
- 画面比例
- 16:9 / 9:16 / 1:1 / 4:3 / 3:4 / 3:2 / 2:3 / 21:9
- 参考素材
- 首帧 1 张或首尾帧 2 张;参考模式最多 9 张图,可再加 ≤3 段参考视频(每段 2–15 秒,合计 ≤15 秒)和 ≤3 段参考音频(WAV / MP3,每段 2–15 秒,合计 ≤15 秒)
- 声音
- 每条都带原生立体声音轨(对白、音效、配乐),不能关
- 提示词
- ≤ 5,000 字符
- Lite 每秒价
- 480P $0.005/秒 · 768P $0.0125/秒
- 成片保留
- 7 天
玩法与 API 字段对照
各玩法共用 model(minimax-h3)、prompt、duration、resolution 和 size。图片放在 images,用 image_role 区分首帧和参考图;不写 image_role 时,图片按首帧处理。
| 玩法 | 传什么 | 得到什么 | 限制 |
|---|---|---|---|
| 文生视频 | 只传 prompt 和生成参数。 | 按文字生成画面和声音;台词、音效、配乐都写进提示词。 | 4–15 秒任意整数,不传 duration 时 5 秒。 |
| 首帧 | images 放 1 张图;不写 image_role 就是首帧,也可以写明 first_frame。 | 成片第一帧就是这张图,按提示词往下拍。 | 不能同时带参考音频或参考视频。 |
| 首尾帧 | images 放 2 张图:第 1 张是首帧,第 2 张是尾帧(image_role 同上)。 | 从第一张画面走到第二张,中间的动作和镜头按提示词生成。 | 不能同时带参考音频或参考视频。 |
| 参考图 | images 放 1–9 张图,并写 image_role: reference。 | 图里的人物、商品、场景出现在新画面里,不当作某一帧。 | 最多 9 张;3 张以上不写 reference 会被拒。 |
| 参考视频 | 参考模式下加 video_references,放视频链接。 | 参考它的动作、运镜或节奏;画面里是谁、在哪里,由提示词和参考图决定。 | 最多 3 段,每段 2–15 秒、合计 ≤15 秒,MP4 / MOV;参考秒数也计费。 |
| 参考音频 | 参考模式下加 audio_references(只有 1 段也可以写 audio_reference),放音频链接。 | 作为参考交给模型。我们实测让角色照它的音色说新台词,两次声音都没有明显变化;对配音要求高时建议后期处理。 | 最多 3 段,只收链接,WAV / MP3,每段 2–15 秒、合计 ≤15 秒,不收费;要和参考图或参考视频一起传。 |
组合规则与注意事项
- 首帧 / 首尾帧和参考模式不能混用:要带参考视频或参考音频,必须写
image_role: reference。首帧模式带了音视频会直接报错,不扣费。参考音频不能单独用,要和参考图或参考视频一起传。 - 图片张数:首帧 1 张,首尾帧 2 张;超过 2 张必须写
reference(最多 9 张),否则报错,不会悄悄丢图。 - 参考音视频的字段是
video_references/audio_references(单数也认);reference_videos、reference_audios、start_frame、end_frame这些写法会被拒,报错里会给出正确的字段名。 - 每条成片都带声音,
audio: false会被拒。不要配乐就在提示词里写non_diegetic_music: N/A。
MiniMax H3 提示词:照官方结构写
以 MiniMax 官方《视频提示词写作指南》为准(基础篇、参考篇)。官方的说法是 H3 比多数模型更看重提示词结构:按镜头写画面,台词放进标签,环境声和配乐各写一段。下面的写法出自官方指南,例句是本页案例实际提交的提示词;标「实测」的是我们自己测出来的。
写法习惯
- 分三段写
integrated_multimodal_description写画面、动作、镜头和台词;overall_soundscape用 1–4 句写环境声和动作声;non_diegetic_music写只有观众听得到的配乐,不要配乐就写N/A。实测:同一个面包店场景用一句话写,台词和切镜也有,但没有配乐、音效对不上;按三段写,木吉他、门铃和切面包声都照提示词出来了。面包店原文开头:“integrated_multimodal_description: [Shot 1] Live-action, cinematic, …”
- 按镜头分段,写清切换时间
第一个镜头
[Shot 1]不写时间,后面的镜头写成[Shot 2] At 00:05.000, the camera cuts to…。本页几条多镜头案例,切换都落在写的时间点附近。面包店原文:“[Shot 2] At 00:05.000, the camera cuts to a close-up of steam rising from the sliced bread”
- 运镜写成「类型 + 幅度 + 速度」
push in、pan、truck、arc shot、tracking shot 这类运镜,加上 with small amplitude、at slow speed,写成句子里的动作,不要在句末堆标签。
面包店原文:“The camera pushes in with small amplitude at slow speed as the middle-aged baker…”
- 台词写进对白标签
说话人用 (S1)、(S2) 编号,先交代年龄、音色,再把台词写成
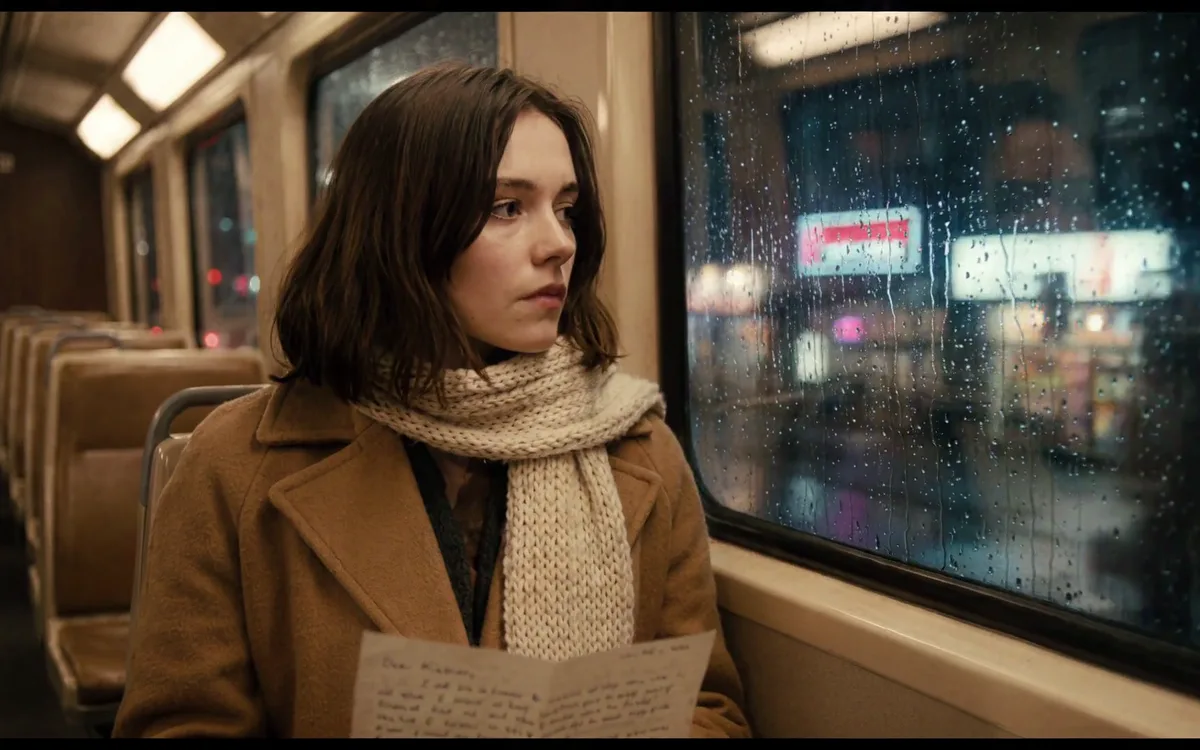
<d>[English] …</d>,原文照写、不要翻译。中文台词写[Chinese]。火车原文:
the quiet, breathy young woman (S1) says: <d>[English] I get off at the next station.</d> - 画面里的字放进引号
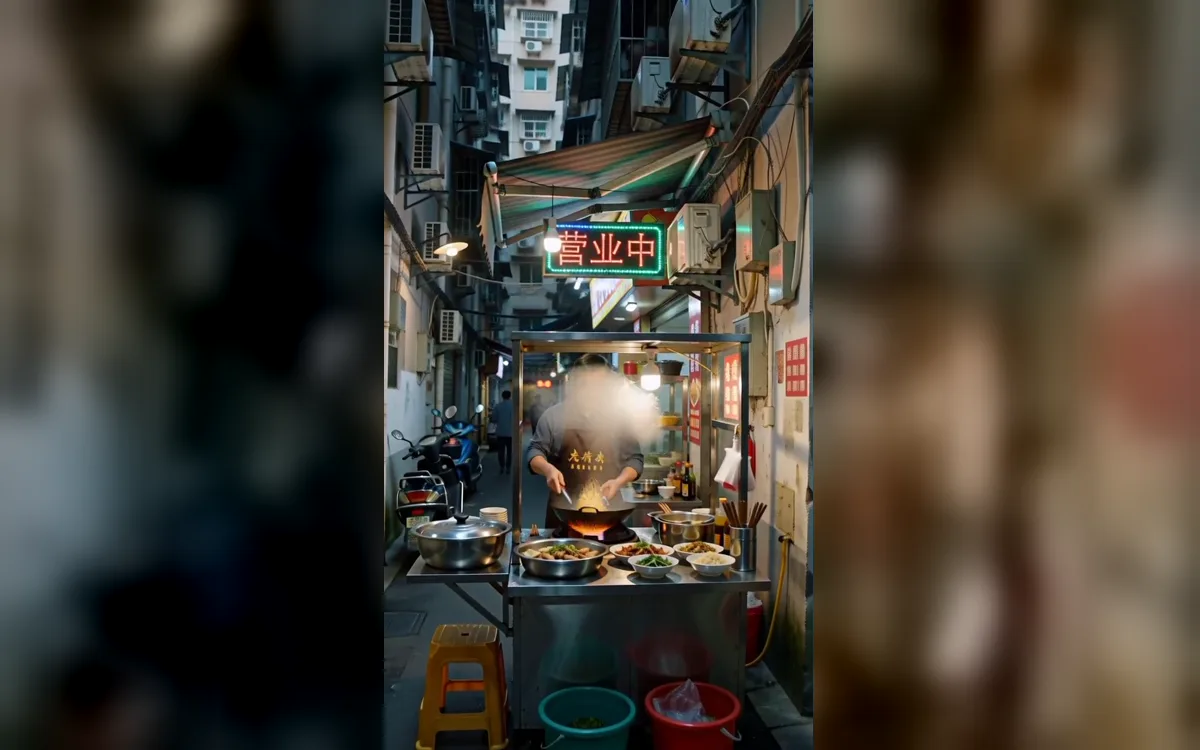
招牌、标语要出现的字放进英文双引号,原样照写。实测「营业中」三个字写对了;没写进引号的背景招牌,字多半是乱的。
霓虹小摊:“A red neon sign reading "营业中" glows above the stall”
- 中文台词会带字幕
实测中文台词的镜头两次都在画面底部加了中文字幕,提示词里写了不要字幕也没去掉;英文台词的几条都没有字幕。要干净的画面,台词用英文,或者后期处理。
霓虹小摊结尾这一句没起作用:“No subtitles or captions appear on screen.”
- 首尾帧写清对齐和路径
首帧任务第一行写对齐指令;首尾帧写明第二张图对上第几秒,正文写中间怎么动,不要把两张静态图再描述一遍。
撑伞原文:“Picture 2 (from Shot 1) aligns with the 8.00-second mark of the target video”
- 参考模式给每份素材起名
用
<Subject 1>、<Picture 1>给每份素材起名,写清它在成片里的作用。实测:照官方亮点页的一句话写法(「Image 1: …, Image 2: …」),成片把三张参考图逐张拍成了几乎不动的镜头;按参考篇的结构重写以后,模特戴上眼镜走起了台步。眼镜广告:
<Subject 3> is the futuristic silver sunglasses in <Picture 3>…
一条长提示词的结构
- 1画面段
以
integrated_multimodal_description:开头,下面按镜头写。原文:“integrated_multimodal_description: [Shot 1] …”
- 2风格与景别
第一个镜头先写风格和景别。
原文:“Live-action, cinematic, a medium-wide shot frames a baker opening the shutters…”
- 3运镜与动作
运镜写类型、幅度和速度,和动作写在同一句。
原文:“The camera pushes in with small amplitude at slow speed as the middle-aged baker… places a fresh loaf on the wooden counter”
- 4台词
说话人编号、音色和台词标签。
原文:
with a calm, slightly raspy voice (S1) … says: <d>[English] First batch of the morning.</d>- 5切镜
新镜头写切换时间和新画面。
原文:“[Shot 2] At 00:05.000, the camera cuts to a close-up of steam rising from the sliced bread”
- 6两段声音
环境声一段,配乐一段。
原文:“overall_soundscape: Wooden shutters scrape open… non_diegetic_music: A soft acoustic-guitar pattern…”
可直接改的模板
integrated_multimodal_description: [Shot 1] [风格,例如 Live-action, cinematic], [景别] frames [主体和场景]. The camera [运镜] with [small / large] amplitude at [slow / fast] speed as [动作]. The [说话人的年龄和音色] (S1) says: <d>[English] [台词]</d> [Shot 2] At 00:0X.000, the camera cuts to [下一个画面].

overall_soundscape: [环境声和动作声,1–4 句]

non_diegetic_music: [配乐的乐器、速度和强弱变化;不要配乐写 N/A]
MiniMax H3 价格
按秒计费,三档各自定价;在线测试提交前就显示这一单的价格。
| 分辨率 | 标准版 | Lite |
|---|---|---|
| 480P | $0.015/秒 | $0.005/秒 |
| 768P | $0.025/秒MiniMax 官方价 $0.08 · 比官方低 68% | $0.0125/秒 |
| 1080P | $0.036/秒 | — |
- 一条的费用 = 所选档位的每秒价 ×(成片秒数 + 参考视频秒数);参考图和参考音频不收费。在计算器里拖动「参考视频」就能算带参考视频的价格。
- MiniMax 官方价目里,H3 只有 768P 和 2K 两档,所以表里只有 768P 能和官方价对照。
- 提交时预扣,成功按同一金额结算;生成失败全额退回。批量打样想再省,可以用 MiniMax H3 Lite。
费用计算器
这一条—
MiniMax H3 在各平台的价格
MiniMax 官方和几家常见 API 平台的公开报价,每格都链到出处。只比同一个 H3 模型的每秒价;官方另有 Highspeed、Lite、Max 等型号,没放进这张表。
| 档位 | 官方 | OpenRouter | fal | Kie | Replicate | KovAPI |
|---|---|---|---|---|---|---|
| 480P | — | — | $0.05 ↗ | — | — | $0.015 |
| 768P | $0.08 ↗ | — | $0.06 ↗ | $0.04 ↗ | $0.08 ↗ | $0.025比官方省 68% |
| 1080P | — | — | — | — | — | $0.036 |
| 2K | $0.13 ↗ | $0.13 ↗ | $0.13 ↗ | $0.065 ↗ | $0.13 ↗ | — |
- 表里的平台都不卖 H3 的 1080P;2K 是在 768P 结果上重新生成的高清版,KovAPI 目前不提供 2K。
- 各平台的价格会变,以出处页面为准;核对日期是我们最后一次逐个打开核对的日期。
同一段提示词,五个档位各出一条
鼠标移到画面上,几条一起播放;手机上点「同步播放」。每条都是单独生成的,画面不会一模一样,比的是清晰度和细节。
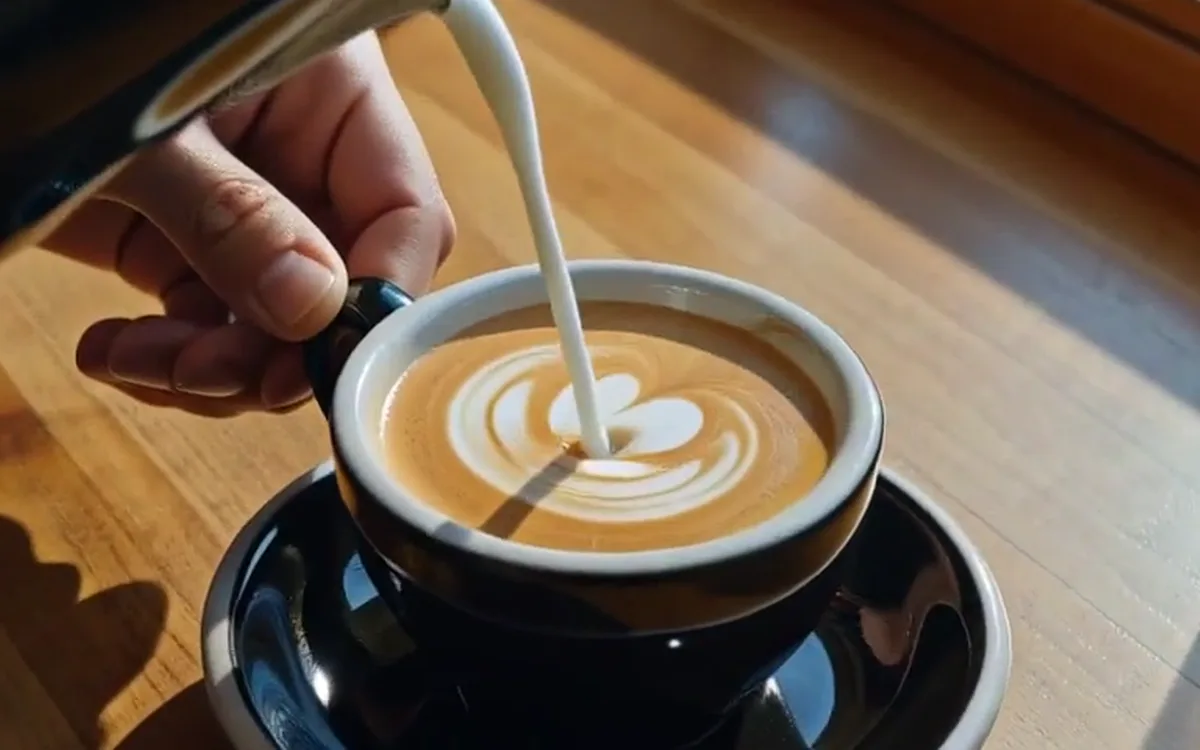
拿铁拉花:H3 三档 + Lite 两档
同一段提示词、同样 5 秒 16:9,分别用 H3 的 1080P / 768P / 480P 和 Lite 的 768P / 480P 各跑一条。打样阶段用 480P 或 Lite 看构图和动作,定稿再出 1080P。
5 秒 · 16:9
1080P
最清楚:拉花纹路、奶壶反光和杯沿都看得清。
768P
细节略少于 1080P,画面依然干净。
480P
构图和动作都看得清,放大后明显发软,适合打样。
768P
出片快、价格低,拉花纹路明显变弱。
480P
最便宜,只适合看构图和动作。
提示词原文
integrated_multimodal_description: [Shot 1] Live-action, cinematic, a close shot of a barista's hands pouring steamed milk into a cup of espresso on a wooden counter by a sunny window. The milk forms a heart in the crema while steam curls upward, and the camera pushes in with small amplitude at slow speed toward the cup.

overall_soundscape: Milk streams into the cup, a steam wand hisses softly in the background and cafe chatter murmurs.

non_diegetic_music: N/A
阅读译文 · 译文只供阅读;复制和套用都用原文
integrated_multimodal_description(画面):[Shot 1] 实拍,电影感,近景:洒满阳光的窗边木吧台上,咖啡师的手把打好的奶倒进一杯浓缩咖啡。奶在咖啡油脂上拉出一颗心,热气往上飘,镜头以小幅度、慢速推向杯子。

overall_soundscape(环境声):奶流进杯子的声音,背景里蒸汽棒轻轻嘶嘶作响,咖啡馆里人声低低的。

non_diegetic_music(配乐):N/A(无)
MiniMax H3 与其他视频模型怎么选
表里的时长、分辨率、参考上限和起步价都是实时规格。
| 型号 | 时长(秒) | 分辨率 | 参考 图 / 视频 / 音频 | 价格 | 适合 |
|---|---|---|---|---|---|
MiniMax H3本页minimax-h3 |
4–15 | 480P / 768P / 1080P | 9 / 3 / 3 | $0.015/秒 起 | 要 1080P 带声短片、首尾帧,或者参考图配参考视频一起用;480P 打样也便宜。 |
MiniMax H3 Liteminimax-h3-lite |
4–15 | 480P / 768P | 5 / 0 / 0 | $0.005/秒 起 | 批量打样、试提示词:同一个 H3,推理步数更少,更快、更便宜,画质略低;只有文生和参考图。 |
Wan 3.0wan3.0-video |
4–30 | 480P / 720P / 1080P | 10 / 5 / 5 | $0.04/秒 起 | 单条要超过 15 秒(最长 30 秒),或者要用文档、网页生成视频。 |
Seedance 2.5seedance-2.5 |
4–30 | 480P / 720P / 1080P | 30 / 10 / 10 | $0.10/秒 起 | 要放进大量参考素材,或者单条最长 30 秒的叙事短片。 |
Seedance 2.0 Fastseedance-2.0-fast |
5–15 | 480P / 720P | 9 / 3 / 3 | $0.052/秒 起 | 要快、预算有限的 Seedance 短片。 |
Gemini Omni 1.2 Flashgemini-omni-1.2-flash |
3–15 | 720P / 1080P / 4K | 3 / 0 / 0 | $0.035/秒 起 | 要用一句话编辑已有视频,或者要 4K、画面文字写得准。 |
Veo 3.1veo-3.1 |
8 | 720P / 1080P | 3 / 0 / 0 | $0.20/条 | 固定 8 秒、按条计费的短片。 |
Grok Imagine Video 1.5grok-imagine-video-1.5 |
4–15 | 480P / 720P / 1080P | 7 / 0 / 0 | $0.025/秒 起 | 按条计费的 480P / 720P 短片,参考图可以给到 7 张。 |
已有其他模型的样片时,用同一组素材和验收标准对比画面、动作、声音、出片耗时和实际费用,再决定换不换。H3 和 Lite 之间怎么选,看上面的同题对比。
如何在 KovAPI 上用 MiniMax H3 生成视频
- 1
- 2
-
3
提交异步生成任务
用
查看 MiniMax H3 API 文档minimax-h3提交到POST /v1/videos/generations,收到 HTTP 202 后保存任务号;完整请求示例见文档。 -
4
查询结果或接收 Webhook
按任务号轮询,或提交时设置
查看 Webhook 文档callback_url接收结果。成功后从data[0].url下载 MP4;成片保留 7 天,请及时保存。
为什么在 KovAPI 使用 MiniMax H3
比官方价低,档位更多
768P 比 MiniMax 官方价低 68%;官方 H3 只卖 768P 和 2K,这里另有 480P 和 1080P 两档,同样按秒计费。在线测试提交前就显示这一单的价格。
失败不扣费,自动重试
生成失败,预扣的费用全额退回;上游繁忙或出错时系统自动重试,不用自己写重试逻辑。
不限并发
每个账号不设并发上限,批量任务直接提交;高峰时自动排队,接口返回 queue_position 和 eta_seconds,完成后可推送 Webhook。
视频模型一套接口
提交、查询和 Webhook 的写法对站内所有视频模型都一样,改 model 就能把同一段提示词交给 Wan、Seedance、Omni 等模型对比。
注册和付款都简单
邮箱或 Google、GitHub 注册,微信、银行卡、PayPal、USDT 都能充值,按量扣费、没有月费;同一把 Key 还能调用站内的对话和生图模型。
MiniMax 视频模型的演进
日期按 MiniMax 官方发布记录;KovAPI 当前可用的玩法以上面的玩法表为准。
- 2025-02-11
T2V-01-Director · 运镜控制
在提示词里写运镜指令,模型按指令推拉摇移;H3 的提示词指南沿用了这一套运镜写法。
- 2025-06-18
Hailuo 02 · 1080P
第二代视频模型,支持 1080P,单条最长 10 秒。
- 2025-10-28
Hailuo 2.3 / 2.3 Fast
肢体动作、面部表情、物理真实感和提示词遵循都有提升;Fast 版只做图生视频。
- 2026-07-31
MiniMax H3 · 第三代当前
文字、图片、视频、音频放在一起理解,画面和立体声一次生成;首帧、首尾帧、参考图、参考视频都在同一个模型里。KovAPI 提供 480P / 768P / 1080P 三档。
MiniMax H3 API 常见问题
MiniMax H3 是什么?
MiniMax 2026 年 7 月发布的视频模型,官方称它是继 Hailuo 01、Hailuo 02 之后的第三代。它能同时理解文字、图片、视频和音频,成片自带声音。在 KovAPI 用
minimax-h3 调用,支持文生视频、首帧、首尾帧、参考图和参考视频。能生成多长的视频?
4–15 秒,按整秒任选,不传
duration 时 5 秒。成片会比请求的秒数多零点几秒,例如 5 秒的任务约 5.2 秒,按请求的秒数计费。三档分辨率怎么选?实际多大?
480P 适合打样和批量,768P 兼顾清晰度和价格,1080P 画面最细,不传
resolution 时为 1080P。16:9 时 480P 是 864×480,768P 约 1344×768,1080P 约 1920×1080;不同任务会差几十个像素。传 720P 可以吗?
可以,按 768P 生成、按 768P 计费。其他取值(例如 2K、4K)提交时直接报错,不扣费。
首帧和参考图怎么切换?
不写
image_role 时,1 张图是首帧,2 张是首尾帧。写 image_role: reference 就是参考图,最多 9 张,图里的人物、商品和场景会出现在画面里,不当作某一帧。要带参考视频或参考音频,必须用参考模式。参考视频能做什么?怎么计费?
可以让成片参考它的动作、运镜或节奏:本页的狐狸就照着一段真人舞蹈跳了同样的动作。参考视频的秒数按所选档位的单价计费,和成片秒数加在一起算,例如 768P、成片 6 秒、参考视频 7 秒,按 13 秒计。最多 3 段,每段 2–15 秒、合计不超过 15 秒。
参考音频有用吗?收费吗?
不收费,最多 3 段,要和参考图或参考视频一起传。官方指南里它可以作音色或配乐的参考;我们实测让角色照参考音频的音色说新台词,两次声音都没有明显变化,所以不建议靠它定音色。
参考素材有什么格式和大小要求?
图片:JPG / PNG / WEBP(不收 GIF),单张不超过 16MB,宽和高都在 256–5760 像素之间、宽高比 0.4–2.5;标准版参考模式最多 9 张,Lite 最多 5 张。参考视频(仅标准版):MP4 / MOV(H.264 / H.265 编码,音轨 AAC / MP3),最多 3 段,每段 2–15 秒、合计不超过 15 秒,单段不超过 50MB。参考音频(仅标准版):WAV / MP3,最多 3 段,每段 2–15 秒、合计不超过 15 秒,单段不超过 15MB。不符合的提交时直接拒绝(编码不对的会在生成时失败),都不扣费。
能关掉声音吗?
不能,每条成片都带音轨,
audio: false 会被拒。不要配乐就写 non_diegetic_music: N/A;要完全无声的素材,下载后去掉音轨。台词能用中文吗?
可以。台词写成
<d>[Chinese] …</d>,我们实测那条中文台词一字不差,但画面底部会自动加上中文字幕,写了不要字幕也没去掉。MiniMax 官方说对白稳定支持中、英、日、韩、西、俄等 11 种语言。提示词正文按官方指南用英文写更稳。能用真人照片吗?
可以。我们用两张普通人的照片测试,作首帧、作参考图各 2 次,都正常出片。请确认你有权使用照片里的人物肖像。
出片要多久?
2026 年 11 月 12 日我们的 30 多条测试里,大多数 2–6 分钟出片,个别超过 15 分钟;分辨率越高、参考素材越多越久,高峰时更久。这是异步任务,提交后用任务号轮询,或设置
callback_url 等通知。生成失败会扣钱吗?
生成失败,未计费,可原样重新提交。提交时的预扣会全额退回,同一任务的自动重试只结算一次。
成片能保存多久?
成片和上传的素材保留 7 天,到期自动删除,请及时下载保存。
H3 和 H3 Lite 怎么选?
MiniMax H3 Lite 是同一个 H3,推理步数更少,更快、更便宜,画质略低;只有 480P / 768P,只做文生和参考图,不收参考音视频。先用 Lite 试提示词和构图,定稿再用 H3 出 1080P。上面的同题对比里可以直接看两者的差别。
H3 和 Wan 3.0、Seedance 2.5 怎么选?
单条要超过 15 秒,用 Wan 3.0 或 Seedance 2.5(最长 30 秒);要首尾帧、低价的 480P 打样,H3 更合适。最好用同一段提示词在几个模型上各跑一条再比。
本页的案例是怎么来的?
都是 KovAPI 通过自己的 API 按页面上的参数生成的,每条都标了生成参数和按现价算的费用。提示词大多照搬 MiniMax 官方指南的原句,输入图由 KovAPI 用自己的图片模型生成。
最后更新 2026-11-12
相关模型
探索其它可接入的模型。
MiniMax H3 Lite
minimax-h3-lite
H3 加速版 · 更快更便宜 · 480P / 768P
$0.013/秒
查看 →
Seedance 2.0
seedance-2.0
文生 / 图生视频 · 5–15 秒
$0.105/秒
查看 →
Seedance 2.0 Mini
seedance-2.0-mini
入门档 · 最省
$0.052/秒
查看 →
Wan 3.0
wan3.0-video
一个接口五种玩法 · 最长 30 秒
$0.065/秒
查看 →

Seedance 2.5
seedance-2.5
文生 / 图生视频 · 最长 30 秒
$0.158/秒
查看 →
Seedance 2.0 Fast
seedance-2.0-fast
低延迟 · 出片快
$0.075/秒
查看 →
Wan 3.0 Prime
wan3.0-video-prime
同能力 · 出片快数倍
$0.120/秒
查看 →
Veo 3.1
veo-3.1
文生 / 图生 / 首尾帧 / 参考图 · 8 秒
$0.200/条起
查看 →