生视频 ● 运行正常 服务状态 →
Wan 3.0
⧉wan3.0-video
Wan 3.0 是阿里通义万相的全能视频模型。在 KovAPI,用同一接口从文字生成视频、用首尾帧安排过渡、用参考素材指定角色和场景,或编辑、延续已有视频;台词、音乐与音效可随画面一起生成。
- 单条最长30秒
- 最多10张参考图
- 标准版1080P比官方低35%
- 失败不扣费
在线测试
直接试一下 Wan 3.0 的效果(登录后可用)。
Input
0 / 20000 字
多张参考图时,可在提示词里用 @Image1 / @Image2 点名第几张,例如「@Image1 的角色站在 @Image2 的场景里」。不点名则由模型自行取用。
参考视频0 / 5
点击上传,或把文件拖到这里
mp4 / mov,单个不超过 50MB;所有参考视频合计最长 15 秒
或粘贴链接
一行一个链接(公网 http(s),或我们的链接)。
可以和参考图一起用:照片定外貌,视频定动作和运镜;提示词里用 @Video1 点名。
参考音频0 / 5
点击上传,或把文件拖到这里
mp3 / wav / m4a,单个不超过 15MB、30 秒
或粘贴链接
一行一个链接(公网 http(s),或我们的链接)。
需要同时有参考图或参考视频;提示词里用 @Audio1 点名。
上传的参考素材保留 7 天。
这就是 POST /v1/videos/generations 的请求体,可以直接改;切回「表单」或点运行时生效。
视频生成通常 5–20 分钟;上游繁忙时可能长到 60 分钟以上(满 120 分钟仍未生成按超时处理,积分全额退还)。请轮询任务号等待,不要重复提交——重复提交会各自扣费。按秒计费、失败全额退。 提示词上限 20000 字(中英文都按字数算)。
Output
video运行后在此显示结果。
🕑 生成的图片和视频保留 7 天,到期自动删除,请及时下载保存。
四种常用玩法,同一个型号
文生视频、首尾帧、多图参考、参考视频改写,各挑一条阿里官方成片;全部输入方式见下方玩法表。
阿里官方示例
鼠标移到画面上播放
输入
首帧 
尾帧
阿里官方示例
鼠标移到画面上播放
输入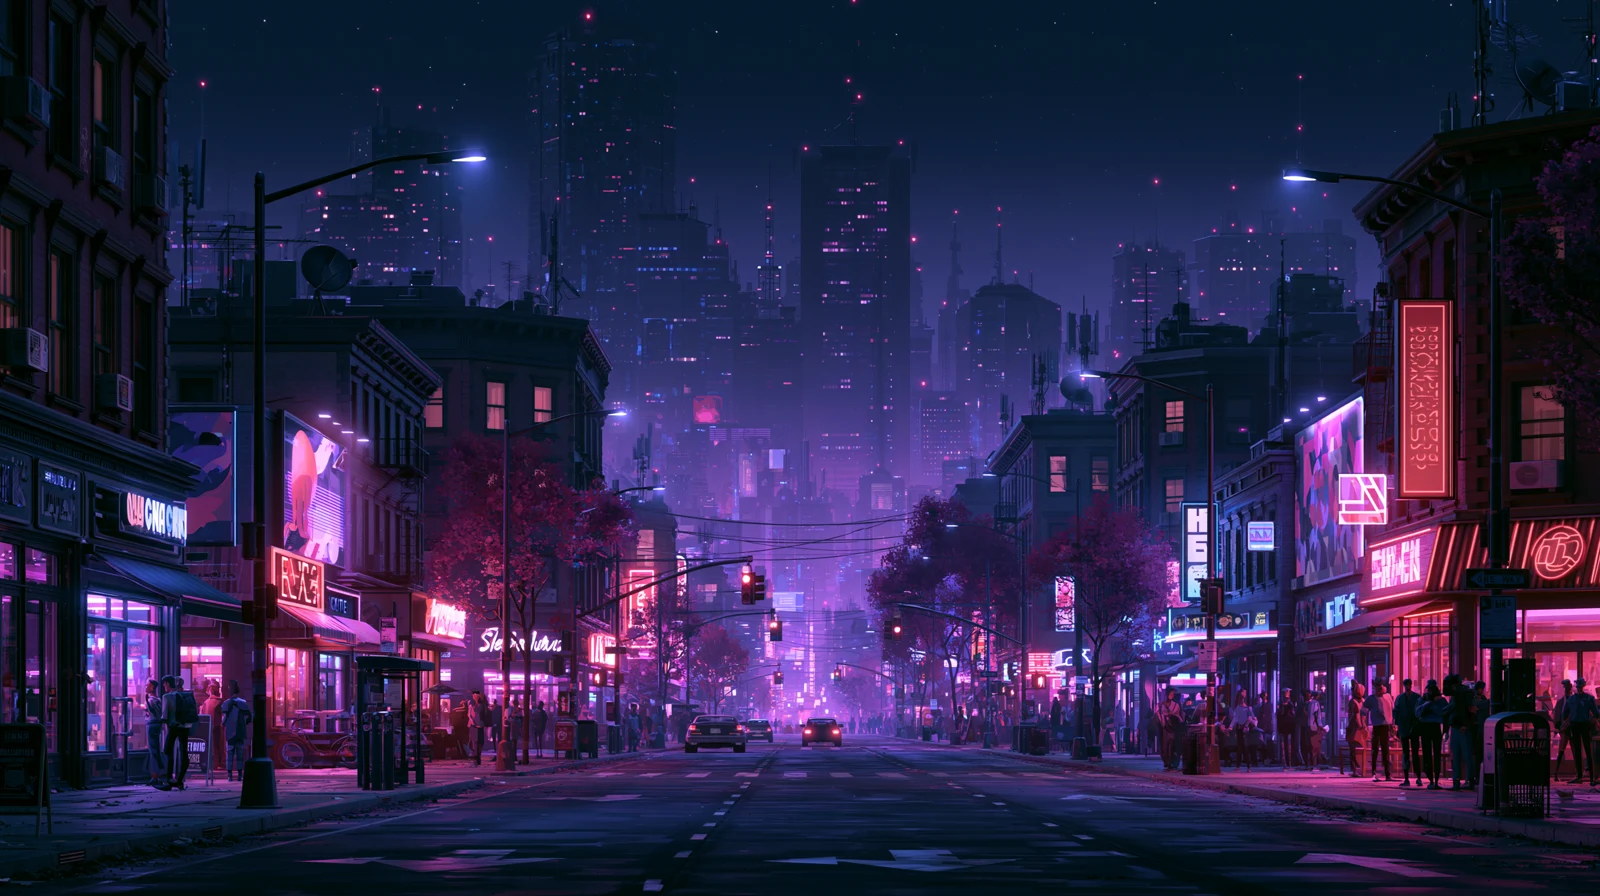
参考图 1 · @Image1 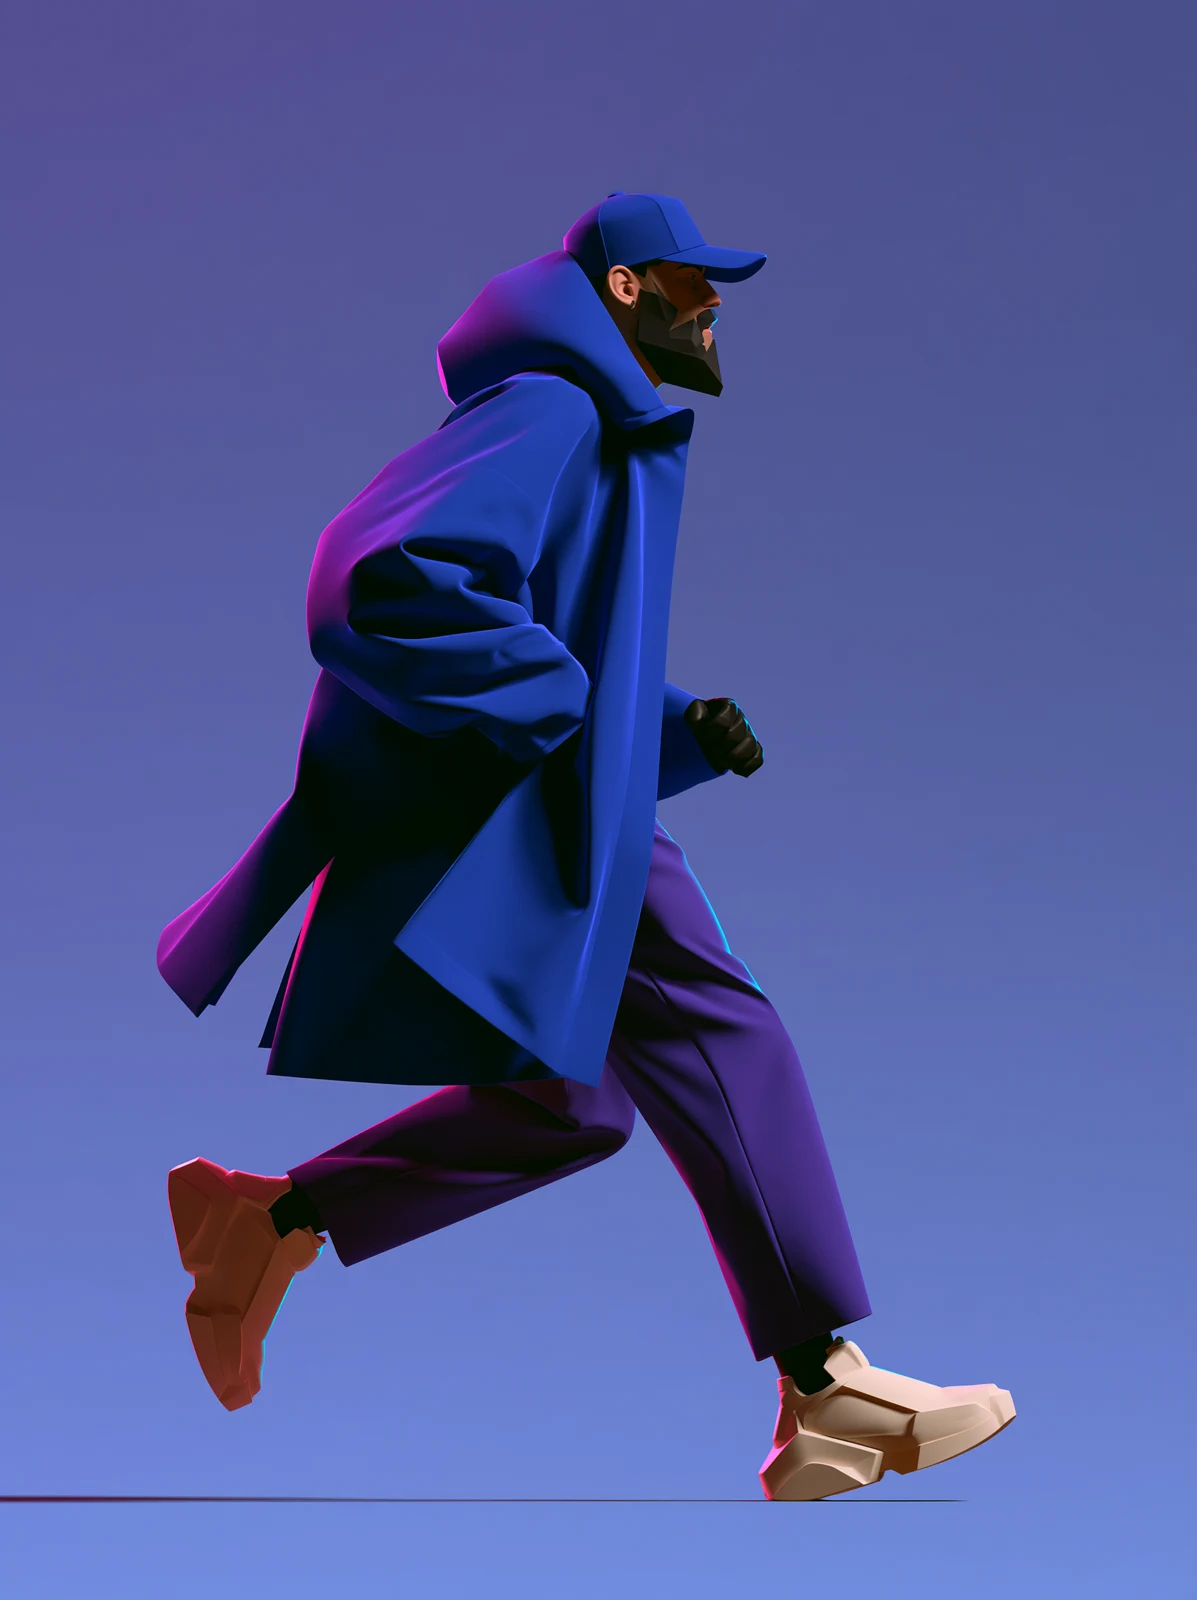
参考图 2 · @Image2 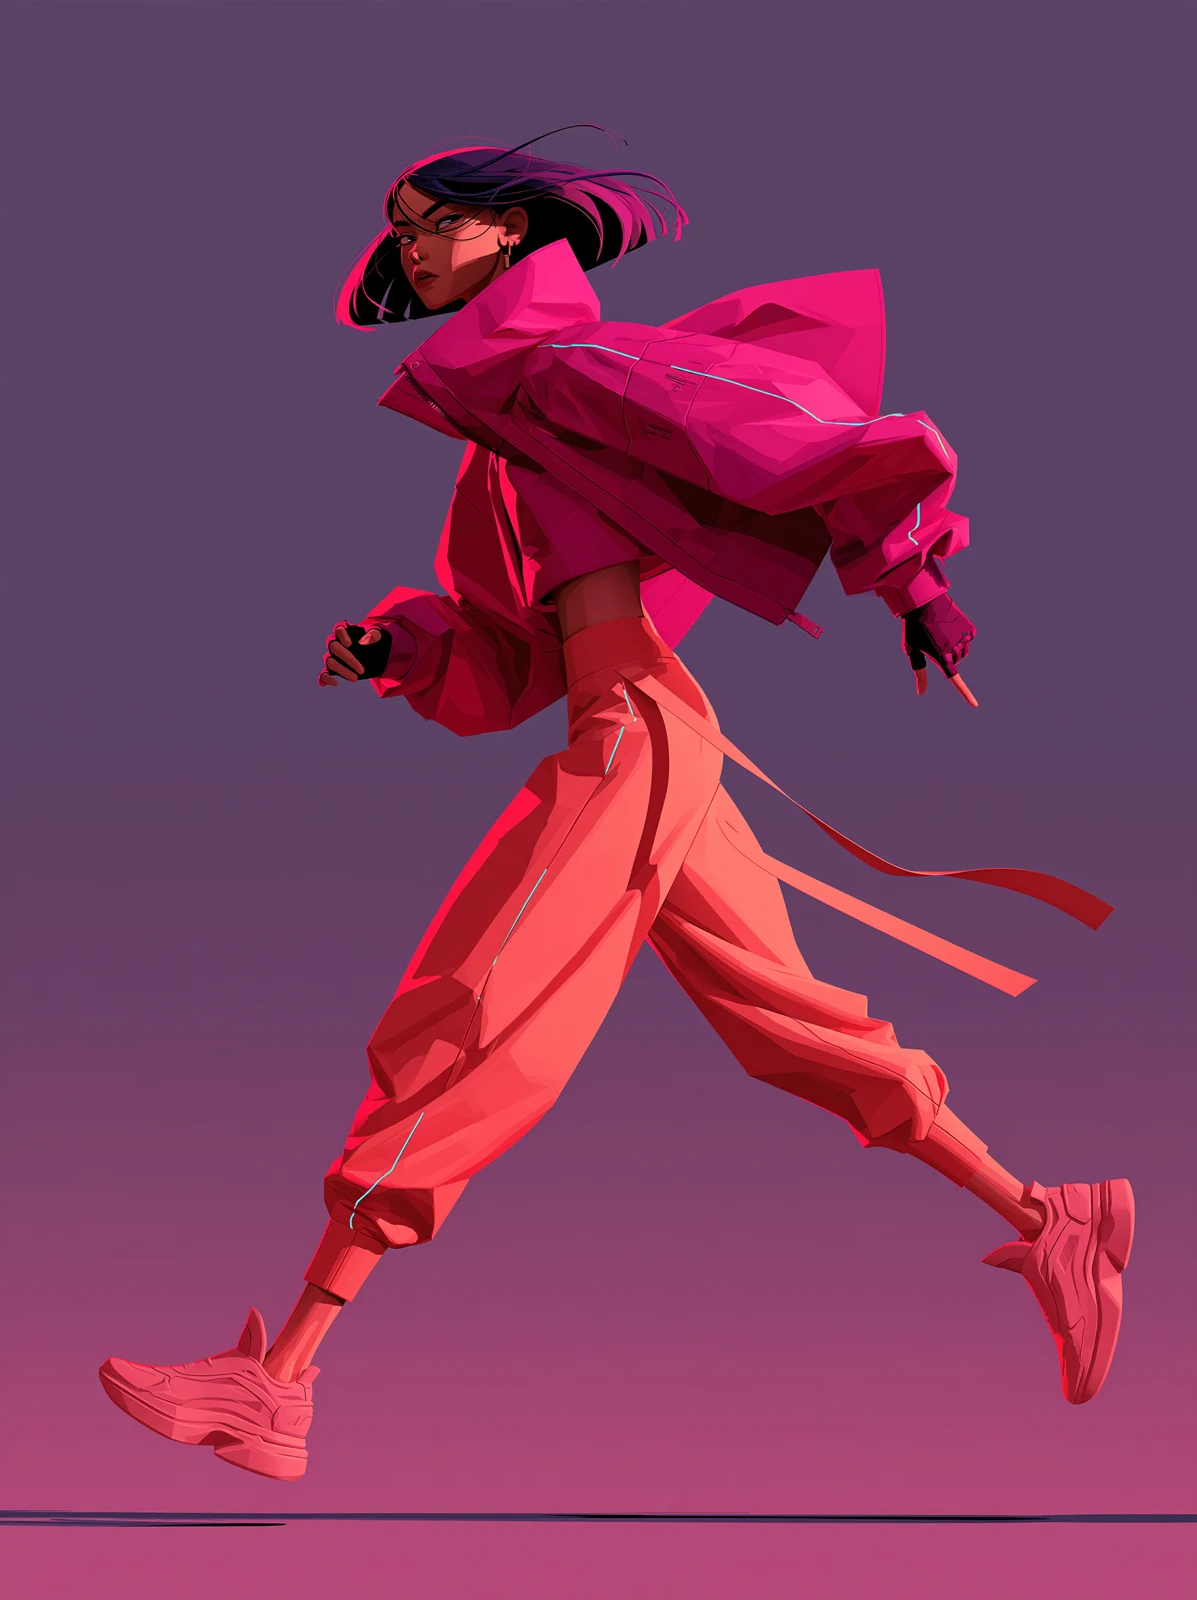
参考图 3 · @Image3
把故事、素材和声音写进同一次生成
下列预览节选自阿里官方案例。点「看完整案例」看带声音的成片和提示词;「相关案例」里是用到同一能力的其他官方成片。
鼠标移到画面上播放
长叙事
从开场动作走到情绪收尾
单条最长 30 秒,可以写一镜到底,也可以写按顺序切换的分镜。#08 用四个镜头交代接近、异象和反应;#38 把 30 秒拆成七个时间段;#64 则是一镜到底的写法。先选叙事方式,再安排人物动作和镜头变化。
相关案例
鼠标移到画面上播放
参考素材
给角色、场景和风格各自分工
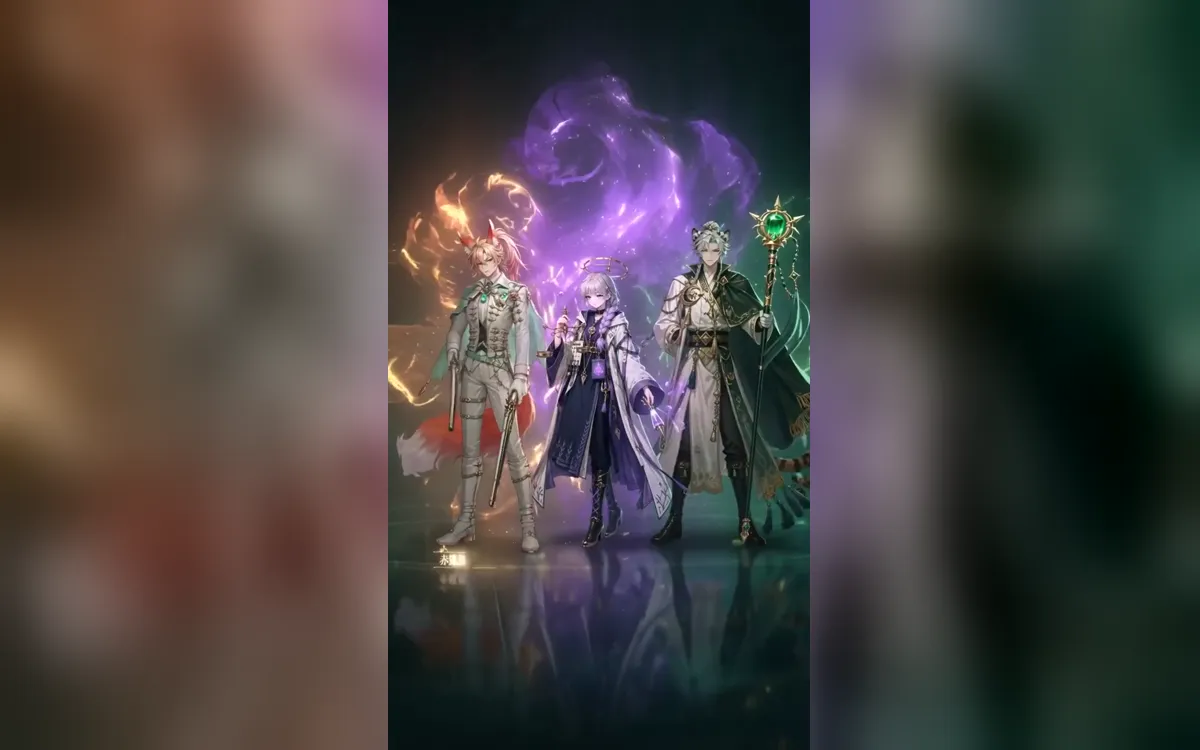
参考图可用于约束角色造型、物体和场景。#36 将三张立绘按绯狩 @Image1、霆岳 @Image2、紫珞 @Image3 分配,再分别写动作、特效与台词。对照输入图和成片,检查各角色的外观与动作。
相关案例
鼠标移到画面上播放
编辑与延续
让已有画面接着讲下去
在已有视频上改写:替换主体、删掉或放大物体、调整光线,也能向前、向后延长。提示词里先说改什么,再列出保留什么。#60 为舞厅片段向前补出了邀舞过程。
相关案例
鼠标移到画面上播放
原生音轨
把台词、音效和音乐安排到动作上
成片自带音轨,台词、环境音、音效和音乐都写在提示词里。#24 把舞蹈动作卡在鼓点和段落变化上;#36 给三个角色各配一句台词并要求口型同步;#64 把吟诵放进指定的时间段。静音预览只展示画面,完整案例保留原声。
相关案例
鼠标移到画面上播放
镜头与光影
写清景别、运动和照明方向
把“电影感”拆成可以核对的要求:景别、推近或环绕、主光方向、色调和材质。#09 把云海逆光与人物情绪写在同一段;#53 只改照明、保留原有动作;#41 借用参考视频的运镜,把场景换成天台咖啡桌。
相关案例
从创作任务选择玩法
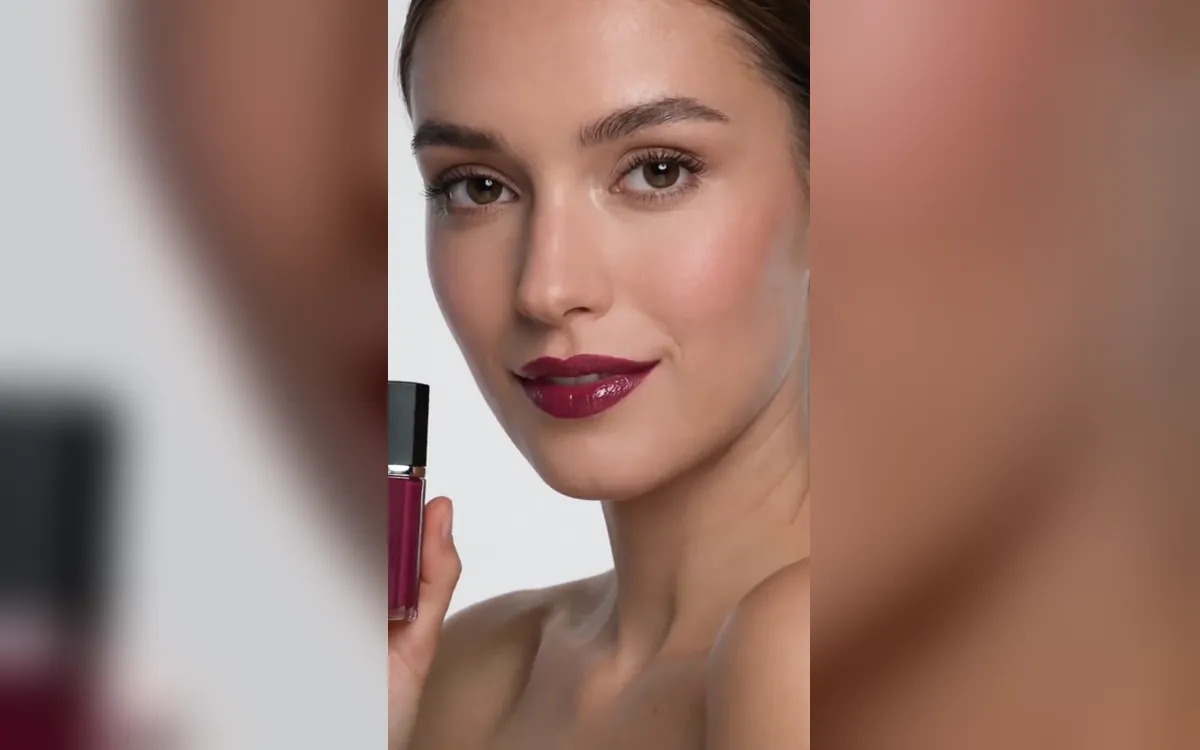
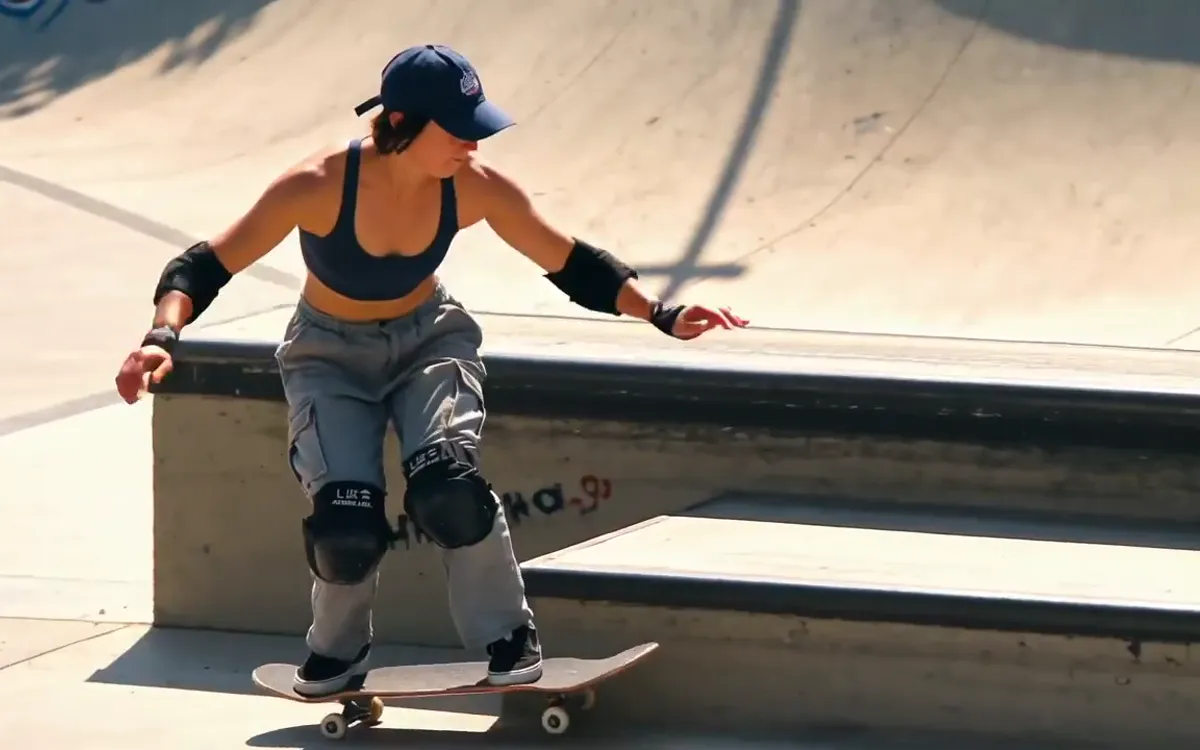
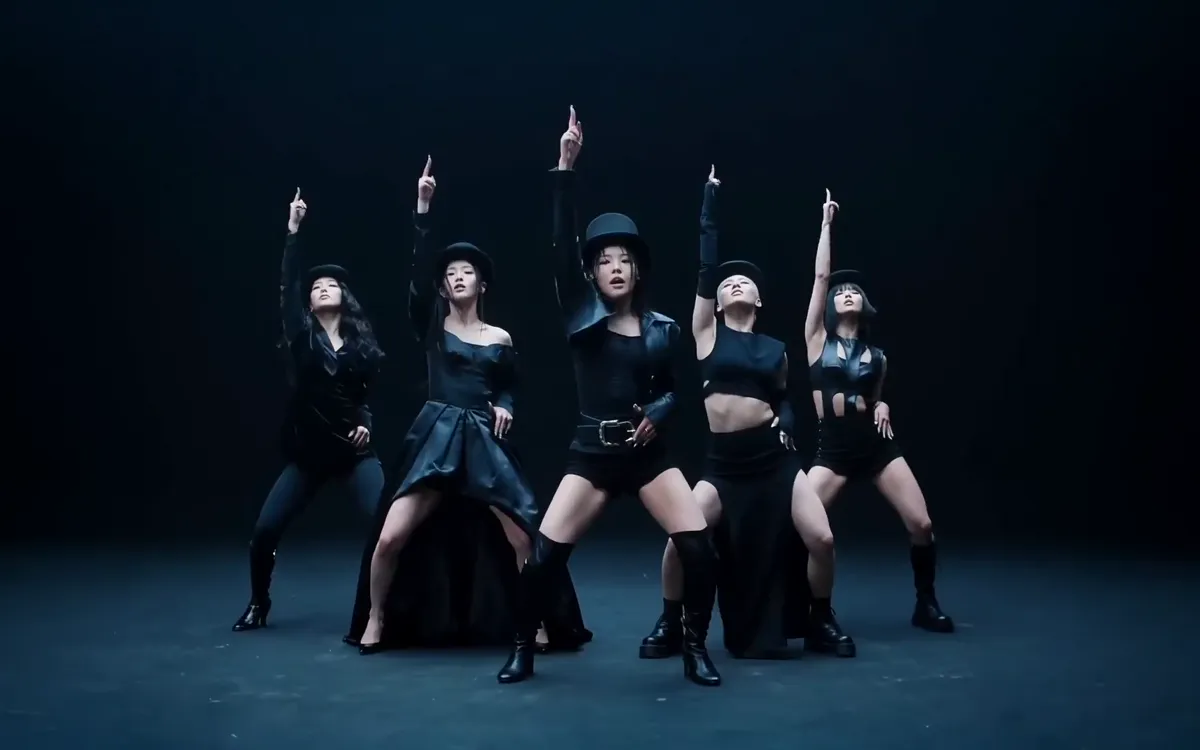
Wan 3.0 规格速查
- 型号 ID
wan3.0-video·wan3.0-video-prime- 接口
POST https://kovapi.com/v1/videos/generations→GET https://kovapi.com/v1/videos/jobs/{id}- 时长
- 4–30 秒,整数
- 分辨率
- 480P / 720P / 1080P
- 画面比例
- 16:9 / 9:16 / 1:1 / 4:3 / 3:4 / adaptive(带首帧时跟随首帧)
- 参考素材
- 图片 ≤10 · 视频 ≤5(合计 ≤15 秒)· 音频 ≤5
- 提示词
- ≤ 20,000 字符
- 成片保留
- 7 天
玩法与 API 字段对照
各玩法共用 model(wan3.0-video 或 wan3.0-video-prime)、prompt、duration、resolution 和 size;参考音频用 audio_reference 传入,最多 5 段。
| 玩法 | 传什么 | 得到什么 | 限制 |
|---|---|---|---|
| 文生视频 | 只传提示词与生成参数,不附参考素材。 | 按文字描述生成场景、动作与声音。 | 只受通用规格限制(见规格速查)。 |
| 首帧生视频 | images 放一张首帧图;可明确写 image_role: first_frame。 | 以给定画面作为开头,生成后续动作。 | size: adaptive 可跟随首帧比例;提示词侧重接下来的变化。 |
| 首尾帧过渡 | images 按顺序放两张图,并写 image_role: first_frame。 | 从首帧向指定尾帧生成过渡。 | 两张图的先后顺序决定起点与终点;带首帧时可用 size: adaptive。 |
| 多图参考 | 在 images 中依次放入图片,写 image_role: reference;提示词用 @Image1 等点名。 | 参考角色、物体、场景或风格生成新画面。 | 最多 10 张图;两张及以上未指定 image_role 时按参考处理。 |
| 参考视频改写与延续 | video_references 每段填写 url 和 duration;可配参考 images、audio_reference。 | 编辑已有画面、参考运镜,或向前、向后延续内容。 | 最多 5 段,参考视频合计不超过 15 秒;参考秒数加成片秒数不超过 30 秒。带参考视频时图片只能作参考。 |
| 文档 / 网页生成视频 | 通过 API 传入一个 file_url 文档链接或一个 link_url 公开网页链接,二选一;文档会先转存,prompt_extend 须为 true。 | 依据文档或网页内容,按提示词生成讲解、摘要或故事视频。 | 格式 docx / doc / xlsx / xls / pptx / ppt / pdf / txt / key / pages / numbers / md,单文件不超过 100 MB;PDF、Word、PowerPoint、Keynote、Pages 文档不超过 50 页。网页须无需登录;可配参考图、视频、音频,图片只作参考。 |
组合规则与注意事项
- 首帧 / 首尾帧只在不带参考视频、文档或网页时可用;带上其中任何一种,图片一律按参考图处理。参考音频不能单独使用,须和参考图或参考视频一起提交。
prompt上限 20,000 个字符;中文和英文都按字符计,标点、空格与换行也计入。- 含真人面部的参考素材可能触发
FaceDetectionSuspect而被拒,失败不计费。 - 文档 / 网页输入目前只能通过 API 提交,在线测试暂无这个入口。
Wan 3.0 提示词:把意图写成可执行的镜头
以《Wan 3.0 视频创作者手册》第五节“提示词指南”为主:先用“主体 + 场景 + 运动”说清谁在哪里做什么,再加入美学控制、风格和音效,明确镜头如何呈现。阿里云 Prompt 指南补充分镜、素材引用与编辑写法。下方节选标明手册编号。长提示词拆解采用手册 #38:先分配参考素材,再按动作因果展开时间段。
写法习惯
- 开头交代片型与规格
先写主体、场景与运动,再交代片型和规格;提示词中的目标时长、比例应与
duration、size一致。#16 原文节选:“生成一支10秒、16:9横版”
- 按上传顺序点名素材
图片、视频和音频分别编号;说明各自用于造型、场景、动作还是声音。KovAPI 图片引用可写
@Image1。#36 原文节选:“赤狐双枪枪手·绯狩 @Image1”、“虎纹兽人法师·霆岳 @Image2”、“人类炼金学者·紫珞 @Image3”
- 为长片安排顺序
分镜按先后排列,需要精确安排时写起止时间;连续镜头也可按动作阶段展开。
#64 原文节选:“[3-7秒:水聚成形]”
- 人物设定只写清一套
先固定发型、服装和识别特征,再写人物的动作与情绪变化。
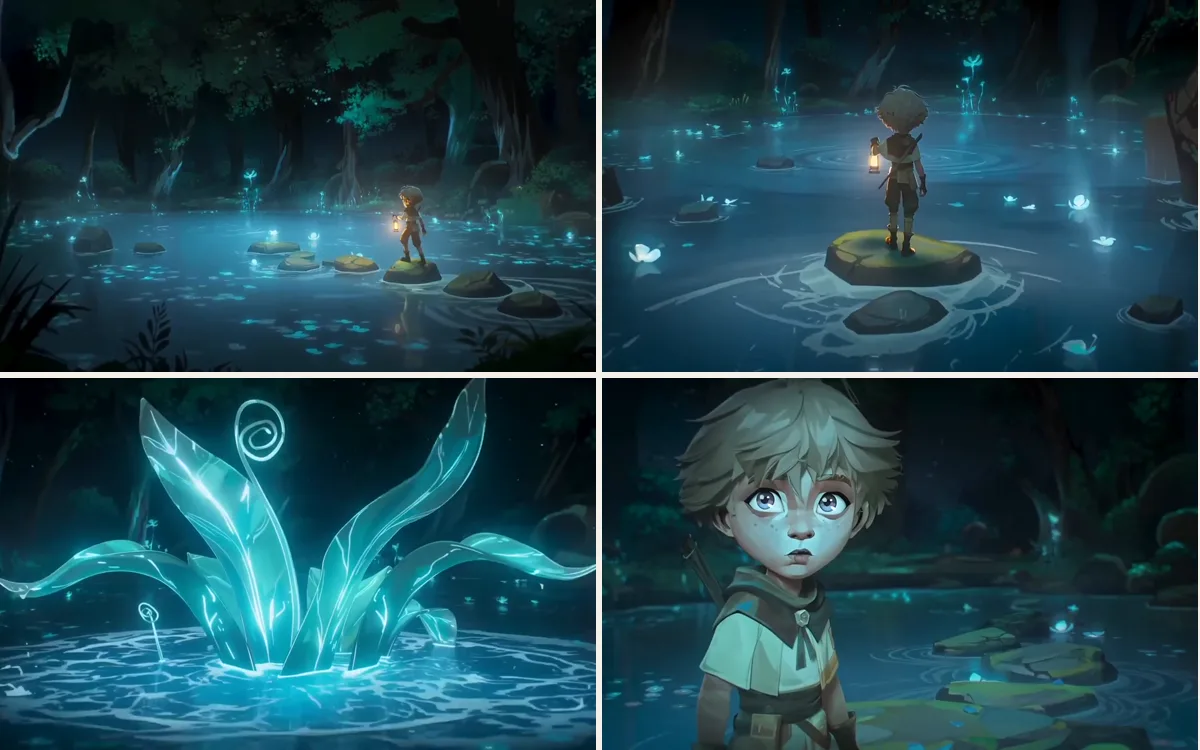
#08 原文节选:“身形纤细,短浅色发,有雀斑,穿轻便探险服,手持小油灯”
- 用动词描述运动与镜头
把移动、停止、推近和切换分开描述,避免只堆风格形容词。
#08 原文节选:“镜头一为中远景定场,探险少年从画面右侧踩着露出水面的石头向湖中心移动,镜头缓慢前推”
- 把声音放到动作发生处
台词写明说话者与内容;环境音、音乐和具体音效分别说明。
#64 原文节选:“第8秒起,一位空灵温柔的女声缓慢吟诵:"欲把西湖比西子——"”
- 编辑时列出保留项
先说要改什么,再说哪些主体、动作和背景保持不变,便于验收。
#33 原文节选:“右侧人物、远处船队和海面雾气保持不变。”
- 用具体约束收尾
写清必须看到的细节与不希望出现的变化,删去重复描述,最后检查字符数。
#24 原文节选:“全片维持黑白高对比硬边光影与冷调影棚质感,无柔光无滤镜”
一条长提示词的结构
- 1总述与参考分工 · #38
先给片型与目标时长,再明确城市、男性、女性分别参考哪张图;素材按上传顺序编号。
#38 原文节选:“图1 @Image1 作为城市空间、霓虹氛围、车道结构和整体视觉质感参考”
- 2视觉风格 · #38
统一画面的图形语言、空间层次和质感,后续动作都在这套风格中展开。
#38 原文节选:“融合扁平MG图形语言、精致2.5D空间层次和克制三维体积感。”
- 3人物动作逻辑 · #38
先写两人的不同优势,让每次接触有目标、动作与反应,便于理解追逐为何继续。
#38 原文节选:“抓、挡、卸力、换手、借力、转身、闪避、反制”
- 4贯穿全片的道具 · #38
明确唯一争夺对象的数量、大小和发光效果,给各阶段提供一致的视觉目标。
#38 原文节选:“它始终只有一颗,大小稳定,不复制、不消失、不变形,运动时只有短促干净的光轨。”
- 5分段时间轴 · #38
原文按七个连续区间推进,先决定事件顺序,再把每段的行动写具体;这些时间码是本案例的镜头安排。
#38 时间段概括:0–4秒登场 → 4–8秒截击 → 8–13秒人群争夺 → 13–16.5秒上车 → 16.5–24秒车流追逐 → 24–27.5秒脱身 → 27.5–30秒收尾。
- 6为动作选择镜头 · #38
说明镜头要帮助观众看清什么,再指定手持、推拉、低机位与遮挡转场。
#38 原文节选:“镜头始终服务光球归属、双方距离和追逐方向,不做无意义花哨旋转。”
可直接改的模板
生成一段30秒、16:9横版的奇幻叙事视频。主体是提着小灯的成年探险者,故事从发现异常发展到理解与平静。
色调与光线:青蓝夜色、柔和月光,小灯提供暖色局部照明。
人物设定:深色短发、绿色外套、浅色背包;全片保持服装、发型与道具一致。
镜头1(0–6秒):远景,探险者沿湖边缓步前行,镜头向前推,脚步声与虫鸣清晰。
镜头2(6–12秒):中景,探险者停下,看向湖面出现的微光,镜头缓慢移向水面。
镜头3(12–18秒):近景,水中的发光花朵展开,细小波纹扩散,加入轻柔水声。
镜头4(18–24秒):侧面中景,探险者放低小灯,表情由警惕变为惊叹,配乐渐强。
镜头5(24–30秒):镜头缓慢拉远,人物和花朵留在同一画面,音乐渐弱,水声延续。
声音:轻柔弦乐、虫鸣、脚步与水声;无台词。
约束:湖岸位置、人物造型和小灯不变,不出现额外人物或文字。
价格
| 分辨率 | 标准版 | Prime |
|---|---|---|
| 480P | $0.04/秒阿里官方价 $0.05 · 比官方低 20% | $0.06/秒阿里官方价 $0.068 · 比官方低 11% |
| 720P | $0.065/秒阿里官方价 $0.10 · 比官方低 35% | $0.12/秒阿里官方价 $0.14 · 比官方低 14% |
| 1080P | $0.13/秒阿里官方价 $0.20 · 比官方低 35% | $0.25/秒阿里官方价 $0.28 · 比官方低 10% |
- 按秒计费:所选分辨率的每秒单价 ×(成片秒数 + 参考视频秒数),每一段参考视频都计入;参考图片、参考音频、文档和网页不另收费。
- 提交时预扣,生成失败全额退回;一个任务无论自动重试几次,只结算一次。
费用计算器
这一条—
Wan 3.0 与其他视频模型怎么选
下表的时长、分辨率、参考上限和价格都是实时规格。先确认素材放得下,再用自己的样片比较画面、动作和声音。
| 型号 | 时长(秒) | 分辨率 | 参考 图 / 视频 / 音频 | 价格 | 适合 |
|---|---|---|---|---|---|
Wan 3.0本页wan3.0-video |
4–30 | 480P / 720P / 1080P | 10 / 5 / 5 | $0.04/秒 起 | 一个型号覆盖文生、首帧 / 首尾帧、多图参考、参考视频改写和文档 / 网页生成,成片自带音轨。 |
Wan 3.0 Primewan3.0-video-prime |
4–30 | 480P / 720P / 1080P | 10 / 5 / 5 | $0.06/秒 起 | 与标准版能力和上限相同、单价更高;阿里官方将它定位为高速档。 |
Seedance 2.5seedance-2.5 |
4–30 | 480P / 720P / 1080P | 30 / 10 / 10 | $0.10/秒 起 | 一条任务要放入更多参考图、参考视频或参考音频时(上限见左列);它的图片只作参考图,没有首帧 / 首尾帧玩法。 |
Seedance 2.0seedance-2.0 |
5–15 | 480P / 720P / 1080P / 4K | 9 / 3 / 3 | $0.07/秒 起 | 已有 Seedance 2.0 样片、希望沿用同一风格的短片。 |
MiniMax H3minimax-h3 |
4–15 | 480P / 768P / 1080P | 9 / 3 / 3 | $0.015/秒 起 | 批量短片:先用 480P / 768P 打样,再出 1080P;能做首尾帧,参考模式可带参考音频和参考视频(规格见左列)。 |
Veo 3.1veo-3.1 |
8 | 720P / 1080P | 3 / 0 / 0 | $0.20/条 | 固定时长、按条计费的短片(时长和价格见左列)。 |
已有其他模型的稳定样片时,用同一组素材和验收标准,对比人物一致性、动作、声音、出片耗时和实际费用,再决定是否切换。
如何在 KovAPI 上用 Wan 3.0 生成视频
- 1
- 2
- 3
-
4
查询结果或接收 Webhook
按任务号轮询,或提交时设置
查看 Webhook 文档callback_url接收结果。成功后从data[0].url下载 MP4;成片保留 7 天,请及时保存。
为什么在 KovAPI 使用 Wan 3.0
比阿里官方价低
标准版 720P 比阿里官方定价低 35%,1080P 低 35%,480P 低 20%;Prime 三档也低于官方。在线测试提交前就显示这一单的价格。
失败不扣费,自动重试
生成失败,预扣的费用全额退回;上游繁忙或出错时系统自动重试,不用自己写重试逻辑。
不限并发
每个账号不设并发上限,批量任务直接提交;高峰时自动排队,接口返回 queue_position 和 eta_seconds,完成后可推送 Webhook。
视频模型一套接口
Wan、Seedance、Veo 等视频模型用同一套接口:同一把 Key、同样的异步任务和 Webhook,换模型只改 model。
注册和付款都简单
邮箱或 Google、GitHub 注册,微信、银行卡、PayPal、USDT 都能充值,按量扣费、没有月费。
万相视频模型的演进
节点日期分别标明开源、预览版上线、系列发布或公测口径;当前 KovAPI 的可用范围以玩法表为准。
- 2025-02
Wan 2.1 · 开源视频模型
阿里在该月开源 Wan 2.1 视频模型,包含文生视频与图生视频。
- 2025-07-28
Wan 2.2 · 运动与画面控制
阿里云上线升级的文生视频与图生视频模型,重点改善复杂运动、画面表现和指令遵循。
- 2025-09-19
Wan 2.5 · 声画同步
预览版上线,加入与画面同步的声音生成,并改进运动表现与提示词执行。
- 2025-12-16
Wan 2.6 · 多镜头与参考生成
阿里发布该系列,加入参考视频生成,并强化多镜头叙事、外观与声音一致性。
- 2026-04-03
Wan 2.7 · 指令编辑
阿里云上线视频编辑等模型,可用自然语言编辑局部或整体画面,并参考动作、特效和运镜。
- 2026-08-06
Wan 3.0 · 统一创作当前
阿里云上线 Wan 3.0 并进入公测,将生成、参考、编辑与延续集中到同一模型;原生生成包含台词、音乐与音效的视频。
Wan 3.0 API 常见问题
Wan 3.0 是什么?
Wan 3.0 是阿里通义万相的全能视频模型。KovAPI 通过
wan3.0-video 提供文生视频、首帧、首尾帧、多图参考和参考视频改写与延续,成片自带音轨。五种基础玩法怎么切换?
通过素材字段与
image_role 切换。纯文字直接生成;一张图默认作首帧,两张图加 first_frame 作首尾帧;多图可作参考,video_references 用于视频改写与延续。单条能生成多长的视频?
可指定 4–30 秒的整数时长。带参考视频时,成片秒数与参考秒数合计不能超过 30 秒;延长任务也按这个合计上限准备素材。
带参考视频时怎么计费?
参考视频秒数与成片秒数一起计费。费用为所选分辨率的每秒单价乘以两者之和;参考图片和音频不另收费,提交前可在在线测试查看报价。
多张参考图会不会把角色混在一起?
参考图可以分别约束不同主体,仍需检查成片中的对应关系。按上传顺序用
@Image1 等点名,写清人物、物品和场景各自的用途,避免同一角色出现矛盾描述。成片有没有声音?
成片自带音轨,可包含台词、环境音效和背景音乐。在提示词中写明说话者、台词内容与出现时机;有参考音频时,将它与参考图或视频一起提交。
出片要多久?
标准版近 7 天真实调用的中位耗时为 2.2 分钟,90% 在 2.8 分钟内完成。这是历史统计;排队时可读取
queue_position 与 eta_seconds,以任务实际状态为准。生成失败会扣钱吗?
生成失败,未计费,可原样重新提交。提交时的预扣会全额退回,同一任务的自动重试只结算一次;参数或素材审核问题请先按返回提示处理。
生成的视频保留多久?
成片保留 7 天。成功后可从
data[0].url 下载 MP4,长期使用请及时保存到自己的存储;保留期以生成任务的实际规则为准。可以用真人照片做参考吗?
含真人面部的参考素材可能被拒,并返回
FaceDetectionSuspect。请优先准备无真人面部的素材;审核导致的生成失败不计费。Wan 3.0 和 Seedance 2.5 怎么选?
需要首帧、首尾帧,或想用文档 / 网页生成时,选 Wan 3.0;一条任务要放入更多参考图、参考视频或参考音频时,可以看 Seedance 2.5(它的图片只作参考图)。两者的时长、分辨率和价格见上方对比表。
wan3.0、Wan 3.0 和 wan3.0-video 是一个东西吗?
Wan 3.0 和 Wan3.0 是模型名称的常见写法;标准版 id 是
wan3.0-video,Prime 是 wan3.0-video-prime。调用时将完整 id 填入 model,不要把展示名称当作字段值。示例是通过 KovAPI 生成的吗?
标有“阿里官方示例”的成片来自通义万相创作者手册。其费用是套用相应参数的当前参考费用;只有明确标注“用 KovAPI 生成”的作品才来自 KovAPI 调用。
可以不轮询,直接收到完成通知吗?
可以,提交时填写
callback_url 即可接收任务结束的 Webhook。通知带签名,投递失败会自动重试;接入细节和完整请求示例见 Webhook 文档。标准版和 Prime 有什么区别?
wan3.0-video 与 wan3.0-video-prime 的能力相同,单价不同。阿里官方将 Prime 定位为高速档;选择时比较当前报价和实测耗时。能用文档或网页生成视频吗?
可以,目前只能通过 API:提交一个
file_url(文档)或一个 link_url(无需登录的公开网页),二选一,prompt_extend 须为 true。文档支持 docx / doc / xlsx / xls / pptx / ppt / pdf / txt / key / pages / numbers / md,单文件不超过 100 MB。最后更新 2026-11-10
相关模型
探索其它可接入的模型。
Wan 3.0 Prime
wan3.0-video-prime
同能力 · 出片快数倍
$0.120/秒
查看 →

Seedance 2.5
seedance-2.5
文生 / 图生视频 · 最长 30 秒
$0.158/秒
查看 →
Seedance 2.0
seedance-2.0
文生 / 图生视频 · 5–15 秒
$0.105/秒
查看 →
Seedance 2.0 Fast
seedance-2.0-fast
低延迟 · 出片快
$0.075/秒
查看 →
Seedance 2.0 Mini
seedance-2.0-mini
入门档 · 最省
$0.052/秒
查看 →
MiniMax H3
minimax-h3
480P / 768P / 1080P · 首尾帧 · 全能参考 · 原生音频
$0.036/秒
查看 →